Claude Code × Codex × Antigravity ― 3つのAIを使い分けて情報調査を回す
 kimurakk
「AIに調べてもらったのに、出てきた情報が古かった」「もっともらしい説明なのに、出典をたどると書いていない」——生成AIを業務の情報収集に使い始めた方が、まず最初にぶつかる壁です。
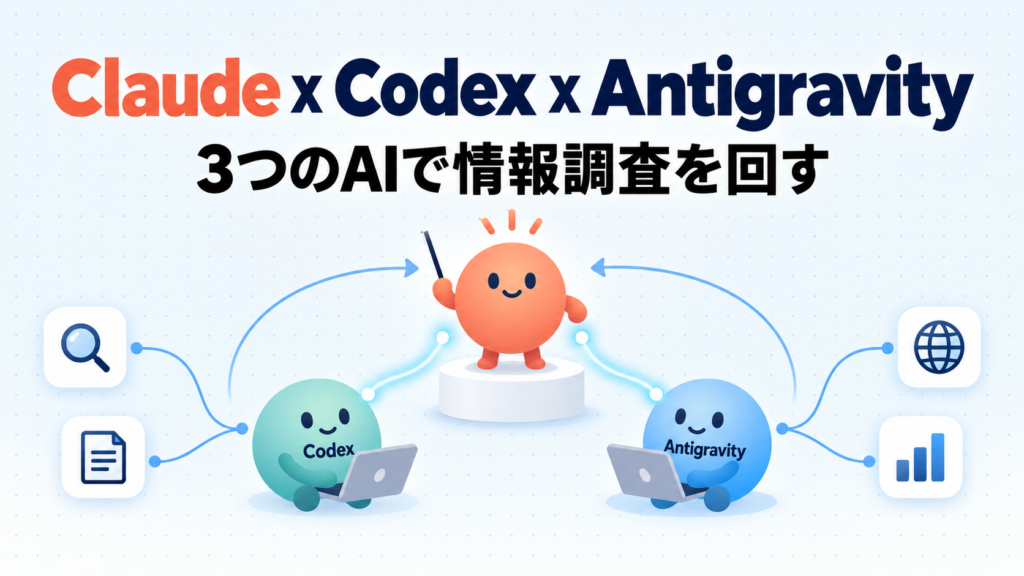
これは「もっと賢いAIを使えば解決する」という話ではありません。調べる工程を分解して、それぞれに向いたAIを割り当てることで、かなりの部分が解消できます。本記事では、AIエージェントのClaude Codeを司令塔に据え、OpenAIのCodex CLIとGoogleのAntigravity CLI(agy)を実働部隊として使い分ける、3つのAIによる情報調査のやり方をご紹介します。
なぜ1つのAIでは調査が終わらないのか
単体のAIに調べ物を任せたときに起きる問題は、だいたい次の3つに整理できます。
- 学習時点より新しいことを知らない: 制度改正、料金改定、バージョンアップ——調査対象になりやすいものほど「最近変わった話」であり、AIが最も苦手な領域です。
- 自分の間違いに気づきにくい: 同じAIに「それ本当ですか?」と聞き返しても、同じ思い込みを補強した答えが返ってくることがあります。間違え方のクセはモデルごとに違うので、別系統のモデルに当てるほうが効果的です。
- コストがかさむ: 高性能なモデルにWebページを何十本も丸ごと読ませるのは、単純に高くつきます。「読む係」と「考える係」は分けたほうが経済的です。
役割分担 ― 司令塔と実働部隊
イメージとしては、調査を外注するときの体制に近いものです。足で稼ぐ部分(検索・資料収集)は数をこなせる担当に任せ、何を調べるかの設計と、集まった情報を採用するかの判断は自分が持つ。これをAIでやります。
| 役割 | 担当するAI | やること |
|---|---|---|
| 司令塔 | Claude Code | 調査の設計、裏取りの判定、最終的な取りまとめ |
| 検索の実働部隊 | Antigravity CLI(agy / Gemini) | Web検索、ページを開いて要点抽出、大量の読み込み |
| セカンドオピニオン | Codex CLI(OpenAI GPT) | 別系統のモデルによる結論の突き合わせ・再検証 |
大事なのは、文章を生成する力はもうどのAIも十分にあるということです。差がつくのは、調査の設計と、出てきた情報を検証して採否を決める部分。そこを司令塔に集中させるのがこの構成の狙いです。
あなた
  │
  ▼
Claude Code(司令塔:調査設計・裏取り判定・統合)
  ├── agy   → Gemini(Web検索・ページ読み・要点抽出)
  └── codex → GPT  (別モデルでのセカンドオピニオン)
準備するもの
1. 3つのCLIを入れる
- Claude Code: 司令塔。ここから他の2つを呼び出します。
- Codex CLI:
npm install -g @openai/codexでインストールし、codex loginで認証します(ChatGPTアカウントでのログイン、またはAPIキー)。 - Antigravity CLI(agy): 公式ドキュメントに従って導入・認証します。
agy modelsでモデル一覧が表示されれば準備完了です。
2. Claude Codeにプラグインを2つ入れる
CLIを入れただけでは連携しません。Claude Code側に、それぞれを呼び出すためのプラグインを追加します。
/plugin marketplace add openai/codex-plugin-cc
/plugin install codex@openai-codex

/plugin marketplace add yuting0624/antigravity-for-claude-code
/plugin install antigravity@antigravity-for-claude-code
導入後、/codex:setup と /antigravity:setup を実行すると、それぞれのCLIがインストール済みか・認証が通っているかを点検してくれます。足りないものがあれば、直すためのコマンドをそのまま教えてくれるので、ここでつまずくことはあまりありません。
実際の調査の流れ
調査そのものは、Claude Codeで次のコマンドを打つところから始まります。
/antigravity:research "調べたいテーマ"この裏側では、次の5段階が回っています。手で指示を出す場合も、この順番を意識するだけで調査の質がかなり変わります。
Step 1: 分解する(司令塔)
テーマを3〜6個のサブ質問に分け、あわせて「ここが崩れたら結論が変わる」という中心的な主張を洗い出します。何を確かめれば調査が終わるのかを、最初に決めてしまうわけです。
Step 2: 手分けして検索する(実働部隊)
サブ質問ごとに1回ずつ、agyに検索を投げます。このとき返させるのは「出典URLと公開日付きの箇条書き5〜8本だけ」。ページ本文そのものは司令塔に持ち込ませません。ここが後述するコスト面の最大のポイントです。
Step 3: 裏を取る(実働部隊)
中心的な主張については、URLを名指しして「その主張を支えている文を原文のまま引用してください。支えていなければ『該当なし』と答えてください」と指示します。これで「○○のサイトによると」というぼんやりした出典が、検証できる引用に変わります。
Step 4: 突き合わせる(司令塔)
独立した2つ以上のドメインで裏が取れたものだけを採用します。出典が1つしかない、URLではなくドメイン名しか示されていない、日付が古い——これらはすべて未検証扱いにします。
Step 5: まとめる(司令塔)
検証済みの事実だけで報告を書き、裏が取れなかったものは「未確認」と明記して残します。消してしまわないのがコツで、「まだ調べ切れていない論点」が可視化され、次に何を確認すべきかがはっきりします。
仕上げ: 別系統のAIに当てる
結論が実務判断に直結するときは、同じ問いをCodex(GPT)にも投げます。
/codex:rescue この結論と根拠に無理がないか、別の見方で検証してください2つのモデルの結論が一致すれば確度は上がります。割れたときのほうが有益で、そこが人間の目で確認すべき論点だと分かります。同じ会社のAIに聞き直しても同じ穴に落ちがちなので、別のモデルファミリーを使うことに意味があります。
中小企業の実務での使いどころ
- 補助金・支援制度の下調べ: 一次情報(公募要領)にたどり着くまでの「地図作り」に使います。要件の最終確認は必ず公募要領そのもので行ってください。
- 競合・市場の一次スクリーニング: 網羅的に候補を洗い出し、深掘り対象を絞り込むまで。
- ITツール・SaaSの比較検討: 価格、機能、移行事例を横並びにする作業は、まさに手分けが効く領域です。
- セキュリティ動向のウォッチ: 脆弱性情報や注意喚起の定点観測。出典と日付が命なので、この進め方と相性が良い分野です。
- 長い資料の読み込み: 議事録や規程類の要約は「読む係」に任せ、判断だけ自分でする、という分担ができます。
コストを膨らませないコツ
- 要約だけ受け取る: 一番効きます。実働部隊には「箇条書きとURLと日付だけ返して」と指定し、生のページを司令塔に読ませない。
- 小さな調べ物は委譲しない: 指示を書いて、受け取って、検証して……という往復のほうが高くつきます。3分で済む調べ物は自分で調べたほうが早くて安い。
- 既定は軽いモデルで: 検索と一次抽出は速くて安いモデルに任せ、引用の裏取りなど難しいところだけ上位モデルに切り替えます。
使う前に押さえておきたい注意点
- 出典の粒度を見る: 「○○省のサイトによると」だけでは裏付けになりません。ページのURL、公開日、できれば原文の引用まで求めましょう。
- 日付を必ず確認する: 検索結果の上位に数年前の記事が並ぶことは普通にあります。制度・価格・バージョン番号は特に要注意です。
- 機密情報を投げない: 顧客名、個人情報、未公開の財務数値などは外部AIへの指示文に含めない。調べたいことは一般化した形で聞くのが原則です。
- 最終判断は人間が持つ: AIの調査結果は「一次情報への地図」と捉えてください。補助金の申請要件や契約条件のように間違えられない情報は、必ず原典にあたって確認します。
まとめ
- 情報調査は「検索する係」「検証する係」「まとめる係」に分解できる
- 検索は速くて安いモデル(agy / Gemini)、設計と統合は司令塔(Claude Code)、結論の突き合わせは別系統(Codex / GPT)
- 効いているのは「AIを3つ使うこと」自体ではなく、裏取りのルールを先に決めておくこと
まずは1つのテーマで回してみて、出てきた出典を自分でも1つ開いてみることをおすすめします。AIの調査結果をどこまで信じてよいか、その感覚がつかめれば、実務で使える道具になります。